Provozujeme AI lokálně: Hardware na pracovní stůl
Jak provozovat středně velké modely pro potřeby kanceláře nebo menší firmy? Vyplatí se investovat do AI pracovní stanice, nebo spíše do dedikované GPU?
Chcete provozovat svého vlastního agenta v malém, například na pracovním stole v kanceláři? V tomto článku se podíváme, jak může vypadat lokální nasazení otevřeného AI modelu s výstupy srovnatelnými s komerčními modely střední třídy (např. Claude Sonnet nebo Gemini Flash) s hardwarem dostupným v ČR v září 2026.
TL;DR:
- Provozovat relativně schopný AI model pro jednotky uživatelů můžete v dnešní době i na pracovním stole.
- Středně velký jazykový model jako Qwen3.8-27B nebo DeepSeek-V4-Flash se dá s rozumným nastavením provozovat na hardware za cca 300 000 korun.
- Na dense modely je lepší dedikovaná GPU, na mixture-of-experts modely AI pracovní stanice.
- Ceny hardwaru jsou v současné době vysoké, ale pravděpodobně ještě porostou.
Jak rozjet lokální modely
Pokud chcete k práci využívat otevřené AI modely, máte následující možnosti:
- Využít externího poskytovatele AI modelů nebo výpočetní kapacity.
- Koupit dedikovanou grafickou kartu (GPU) + potřebný hardware.
- Koupit AI pracovní stanici “vše v jednom”.
První možnost, tedy používat modely vzdáleně, je výhodná v tom, že nemusíte řešit praktikálie ohledně nasazení. Částečně se tím ale vzdáváte záruk na soukromí a možnosti řešit si věci po svém. Zároveň se tím uvazujete k pravidelným platbám, které budou v krátkodobém horizontu levnější, ale přicházíte tím o možnost amortizace nákladů v delším horizontu. Modely se stejnými hardwarovými požadavky už se budou jen zlepšovat – vlastní hardware proto může být čím dál větší výhodou.
V tomto článku se budu proto soustředit na další dvě možnosti: nákup AI pracovní stanice versus dedikované GPU. Ten nejhmatatelnější rozdíl je v tom, že zatímco u AI pracovní stanice získáte lehce futuristicky vypadající krabičku připomínající desktopový počítač, na které můžete stisknout tlačítko “ON” a za chvíli už spouštět vLLM, u GPU získáte podezřele velký podlouhlý objekt s výraznými vrtulemi, ke kterému si musíte nejdříve zajistit potřebné železo.
I pokud si ovšem poradíte s nasazením hardwaru, vyplatí se porovnat i řadu dalších parametrů. Není náhodou nákup dedikované GPU a vlastního hardwaru k tomu levnější, než ono řešení “vše v jednom”, které nabízí AI pracovní stanice? Jak je to s rozšiřitelností, pokud se rozhodnete provoz AI modelů škálovat? Jaké modely se na tom dají rozjet? S jakou odezvou? Kolik uživatelů to zvládne najednou? A dá se tento hardware používat i jako topení v zimě rozjet s relativně rozumnými nároky na příkon a chlazení?
Tyto otázky probereme v tomto článku v kontextu současného stavu trhu v ČR. Zároveň k tomu přidáme odhady rychlosti provozu dvojice aktuálních otevřených jazykových modelů střední velikosti: Qwen3.8-27B a DeepSeek-V4-Flash.
AI pracovní stanice
AI pracovní stanice je řešení “vše v jednom” s kompaktními rozměry. Kromě všech běžných součástí desktopového počítače obsahují AI pracovní stanice především specializovaný akcelerátor pro provoz AI modelů.
Výpočetní jednotky tohoto akcelerátoru mohou mít v jádru stejnou architekturu jako dedikované GPU – např. u NVIDIA řešení je to v současnosti architektura Blackwell. Rozdíl je v tom, že u AI pracovní stanice tento akcelerátor sdílí paměť RAM s procesorem (CPU), zatímco dedikované GPU mají vlastní oddělenou paměť nazývanou VRAM.1 Sdílená paměť je obecně levnější a můžeme jí mít tedy více za stejnou cenu, ale zase je obecně pomalejší. To bude hrát roli při uvažování o nasazení konkrétních modelů.
V současnosti jsou v prodeji tři různá řešení AI pracovních stanic od tří hlavních hráčů na tomto poli:
- Řešení od NVIDIA: Stanice postavené na GB10 Grace Blackwell
- Řešení od AMD: Stanice postavené na AMD Ryzen AI Max+ 395 (Strix Halo)
- Řešení od Apple: Stanice Mac Studio M3/M5 Ultra
Řešení od NVIDIA
Vlajkovou lodí řešení na GB10 Grace Blackwell je NVIDIA DGX Spark: AI pracovní stanice z října 2025. Tato stanice má následující parametry:
- 15×15×5 cm
- ARM64 CPU s 20 jádry
- NVIDIA GB10 Grace Blackwell AI čip s 128 GB (119 GiB) RAM
- Bandwidth 273 GB/s
- 4 TB disk
Tento hardware přímo od NVIDIA ale není jediné řešení postavené na NVIDIA čipu. Existují zároveň i “klony” (=systémy integrující stejný čip) této pracovní stanice od řady dalších výrobců:
- ASUS Ascent GX10
- Dell Pro Max GB10
- HP ZGX Nano
- Acer Veriton GN100
- MSI EdgeXpert MS-C931
- Lenovo ThinkStation PGX
- Gigabyte AI TOP Atom
Všechny najednou si můžete prohlédnout na následujícím obrázku:
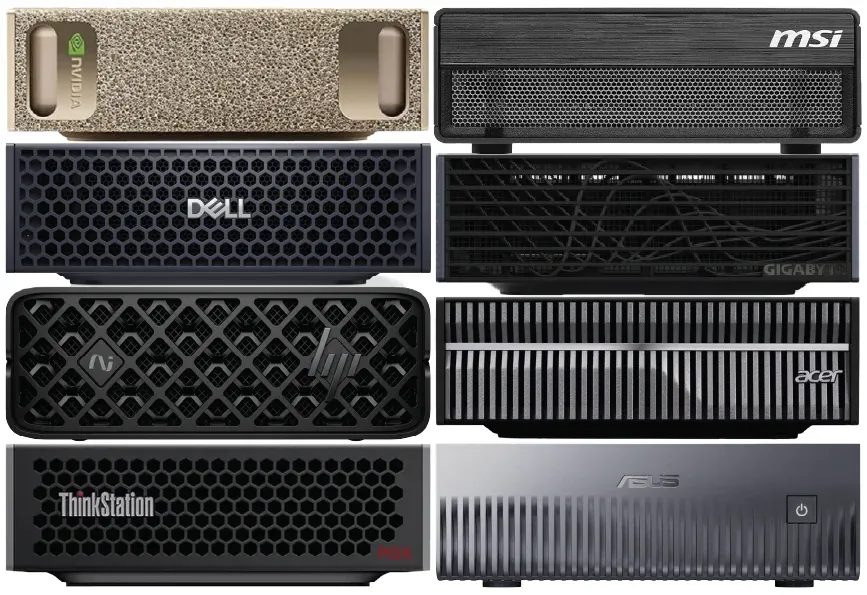
Tyto “klony” jsou v podstatě ekvivalentní až na pár detailů:
- Některé nabízejí i levnější konfigurace s 1 TB nebo 2 TB disky.
- Některé mají lépe pořešené chlazení než původní NVIDIA DGX Spark.
Jinak se od nich dá očekávat naprosto stejná hardwarová platforma, podpora, atd.
Na českém trhu je k současnému datu k nalezení většina z nich: ASUS, Dell, HP, Acer, Lenovo i Gigabyte (v řadě e-shopů ale nejsou na skladě). Cena výrobků, které jsou momentálně dostupné, se pohybuje kolem 150 000 Kč s DPH.
Propojení stanic
Řešení od NVIDIA jsou zajímavá tím, že je lze mezi sebou přímočaře propojit a efektivně tím znásobit kapacitu celkového řešení.
Znásobí se nejen místo na disku a RAM, ale i se správnou konfigurací bandwidth: trochu překvapivě se tedy dá pomocí více kusů zařízení i zrychlit provoz modelů (viz odhady dále).
Oficiálně2 jsou podporována následující řešení:
- dvě zařízení: přímé propojení jedním kabelem,
- tři zařízení: přímé propojení třemi kabely do “prstence” (každé zařízení využije obě dvě své zdířky na kabel),
- čtyři zařízení: propojení pomocí čtyř kabelů a switche.
Řešení od AMD
AMD nabízí ekvivalent NVIDIA DGX Spark v podobě AMD Ryzen AI Halo: AI pracovní stanice postavené na Ryzen AI Max+ 395. Nabízí téměř stejné parametry:
- 15×15×4,5 cm
- Ryzen AI Max+ 395 čip s 128 GB RAM
- Bandwidth 256 GB/s
- 2 TB disk
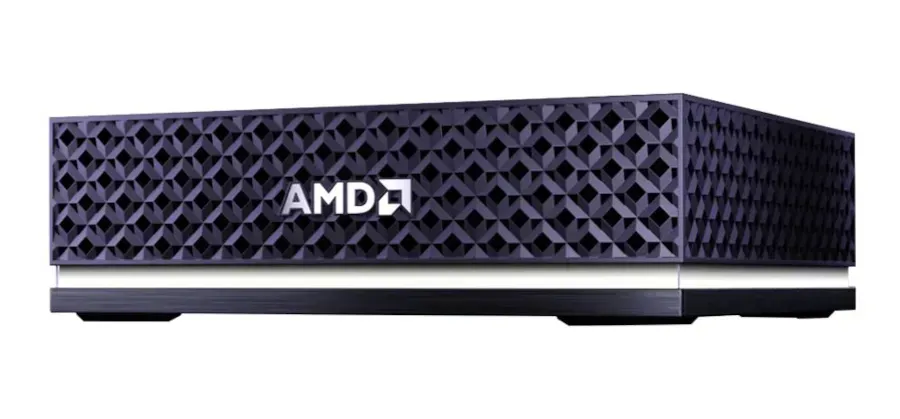
Stejně jako u DGX Spark, i zde existují implementace od dalších výrobců:
Tyto produkty zatím na českém trhu nejsou dostupné, ale pravděpodobně alespoň některé z nich v řádu měsíců budou. Jejich výhodou by mohla být nižší cena, než u NVIDIA řešení. Pozor ale na to, že ekosystém pro provoz modelů zatím na AMD řešeních zaostává. Například podpora vLLM pro AMD je spíš experimentální, AMD čipy nemají podporu pro některé moderní formáty vah modelů a většinou vychází hůř oproti NVIDII v podobných konfiguracích.
Určitou výhodou AMD řešení je to, že je postavené na standardní x86 platformě, zatímco NVIDIA řešení je postavené na ARMu. S tím souvisí to, že AMD přichází s předinstalovanými Windows 11, kdežto NVIDIA staví na DGX OS, což je fork Ubuntu.3
Řešení od Apple
Donedávna byla vlajkovou lodí AI pracovních stanic od Apple Mac Studio M3 Ultra. To se prodávalo v konfiguraci s až 512 GB RAM, což je znatelně více, než řešení od NVIDIA nebo AMD. Apple ale kvůli nedostupnosti pamětí ponechal v prodeji pouze konfiguraci s 96 GB RAM, která vycházela oproti konkurentům spíš hůř.
To se ovšem změnilo s ohlášením Mac Studio M5 Ultra několik týdnů nazpět. Tato AI pracovní stanice by měla v nejvyšší konfiguraci nabízet následující parametry:
- 19,7×19,7×9,5 cm
- Apple M5 Ultra čip s až 512 GB RAM
- Bandwidth 1,2 TB/s
- až 16 TB SSD
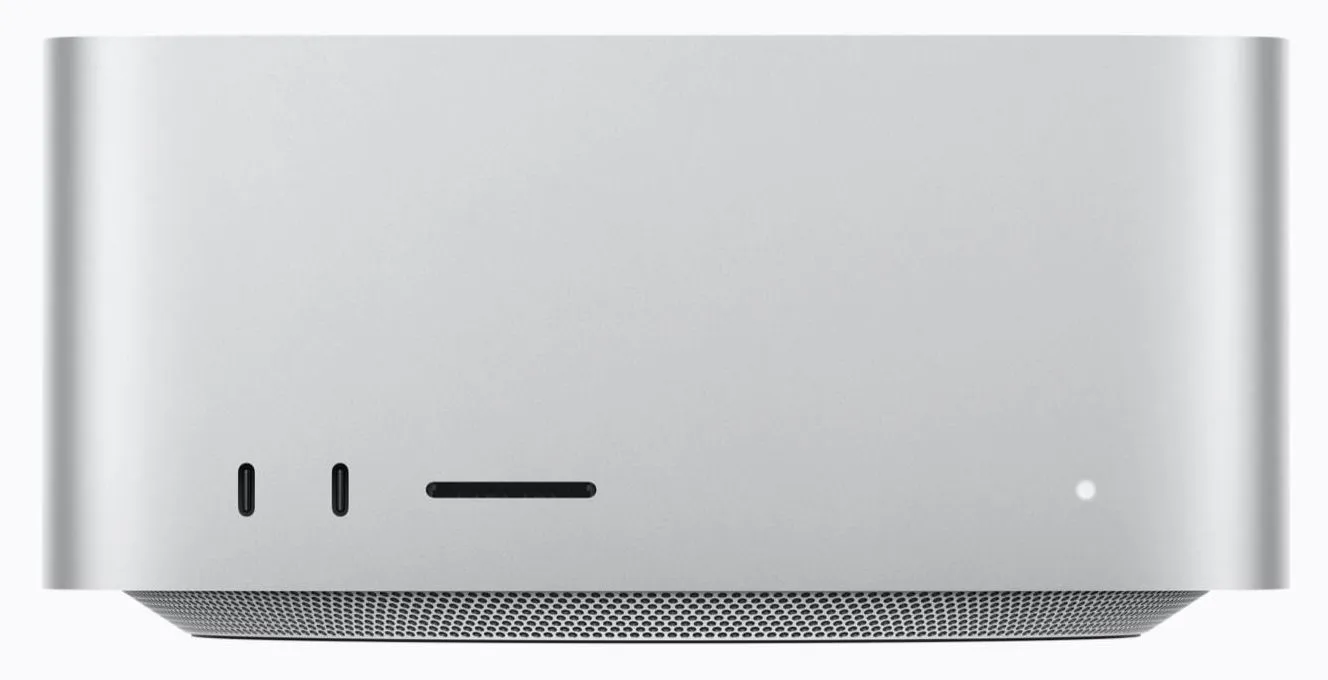
Apple na to tedy jde maximalisticky: v nejvyšší konfiguraci je bandwidth, RAM i kapacita disku násobně vyšší, než u řešení od NVIDIA nebo AMD. Je ovšem otázka, které z těchto řešení bude dostupné a kolik bude stát. Podle aktuálních nabídek v českém předprodeji to vypadá, že nejvyšší dostupná varianta bude s 256 GB RAM a 4-8 TB SSD, a to cca za cenu dvojice NVIDIA DGX Spark, tedy se srovnatelnými parametry (ačkoliv Mac nabízí cca 2× vyšší bandwidth). Uvidíme, jestli Apple svůj produkt tentokrát podrží, nebo jestli bude muset přistoupit k podobnému kroku, jako s předchozím modelem.
Zároveň je potřeba podotknout, že i pro Mac je podpora nasazení lokálních modelů spíš experimentální, ačkoliv jeho MLX framework (ekvivalent CUDA) v současnosti nabírá na popularitě.
Dedikovaná GPU
Na poli dedikovaných GPU existuje celá řada různých řešení, ale většina z nich není vhodná pro provoz středně velkých nejnovějších lokálních modelů. Například cena NVIDIA GeForce RTX 5090 s 32 GB VRAM se na českém trhu pohybuje kolem 130 000 Kč, ovšem s tímto množstvím paměti se dají rozběhnout v rozumné kvalitě jen menší modely do ~10-20B parametrů.
Ačkoliv i menší GPU mohou pro provoz modelů posloužit (například pokud máte karet více z dob, kdy byl tento hardware levnější), zde se budu soustředit na jedno konkrétní řešení pro provoz AI modelů v oblasti dedikovaných GPU, které nabízí zajímavé srovnání s AI pracovními stanicemi: NVIDIA RTX PRO 6000 Blackwell.
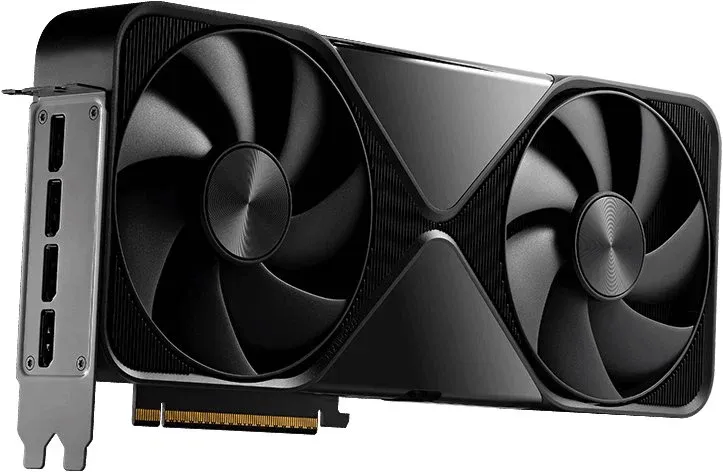
Jedna karta NVIDIA RTX PRO 6000 Blackwell nabízí 96 GB VRAM a stojí na českém trhu kolem 300 000 Kč. Karta se prodává ve třech variantách:
- Workstation edition: až 600 W, systém chlazení “flow-through dual-fan” vhodný pro individuálně provozovanou kartu
- Max-Q Workstation edition: 300 W, systém chlazení (blower) vhodný pro sestavu více karet najednou, lehce nižší výkon
- Server edition: 400-600 W, pasivní chlazení, určená do 1U/2U serverů (tedy ne na pracovní stůl)
Pro provoz samostatné karty je zároveň potřeba nakoupit odpovídající počítačovou sestavu. Při nákupu takovéto sestavy hraje hlavní roli dostatek běžné RAM pro CPU, dostatečně velký a rychlý disk, a odpovídající chlazení. Claude mi pro takovouto počítačovou sestavu dal hrubý odhad na cca 50 000 Kč pro provoz jedné karty (odhad berte s rezervou).4
Celkově tedy jedna karta + HW vychází na něco kolem 350 000 Kč.
Intermezzo: vývoj cen
Ceny hardwaru momentálně rostou vzhůru kvůli celosvětovému nedostatku RAM pamětí a dalších čipů. Například NVIDIA DGX Spark se původně začal v USA prodávat za $4 000 (cca 82 000 Kč), oficiální cena ale mezitím vyrostla na $4 699 (97 000 Kč).
Tato krize se dotýká všeho počítačového hardwaru a podle predikcí nelze očekávat brzký pokles cen. Spíš to vypadá, že v nejbližších měsících ceny porostou ještě výše. Proto to vypadá, že se hardware vyplatí nakupovat spíš teď, než čekat, že ceny spadnou.
Provoz modelů
Co konkrétně očekávat od provozu modelů na AI pracovní stanici versus na dedikované GPU? Budu to ilustrovat na dvou konkrétních modelech a dvou hardwarových variantách:
Modely
| model | typ | par. celkem | par. aktivních | zákl. kvantizace | GB par. celkem |
|---|---|---|---|---|---|
| Qwen/Qwen3.8-27B | dense | ~27,8B | ~27,8B | 16-bit | ~56 GB |
| deepseek-ai/DeepSeek-V4-Flash-0731 | MoE | ~284B | ~13B | kombinace 8-bit a 4-bit | ~167 GB |
Typově jde o dost odlišné modely, což vynikne v dalším porovnání. Váhy obou těchto modelů se velmi pohodlně vejdou i na 1 TB místa na disku.
Hardware
| hardware | kapacita RAM | bandwidth | výkon5 |
|---|---|---|---|
| 2× NVIDIA GB10 Grace Blackwell (DGX Spark) | 2×128 = 256 GB | 2×273 = 546 GB/s | ~2×500 = 1 000 TFLOPS |
| NVIDIA RTX PRO 6000 Blackwell | 96 GB | 1 792 GB/s | ~2 000 TFLOPS |
Půjde tedy o porovnání dvojice AI pracovních stanic a dedikované GPU, obojí v součtu za cenu kolem 300 000 Kč. Za “DGX Spark” si můžeme dosadit kterýkoliv ekvivalentní hardware.
Technické faktory
Pro provoz modelů je potřeba zohlednit tři základní faktory: kapacita RAM v GB, bandwidth (propustnost) v GB/s a výkon ve FLOPS.
Kapacita RAM určuje, jestli se dá model vůbec provozovat (více v tomto článku). Z našich modelů se Qwen 3.8 s 56 GB vah vejde bez problémů do RAM obou AI čipů i v základní (16-bitové) kvantizaci. S kontextem 262k tokenů zabere odhadem 73 GB celkem – KV cache je u něj relativně malá díky hybridní architektuře. Zato DeepSeek-V4-Flash se 167 GB vah vejde pouze do dvojice DGX Spark, a to i přes to, že je už v základu kvantizovaný na kombinaci 8-bitového a 4-bitového formátu.6
Bandwidth a výkon pak určuje, jak rychle model poběží. Provoz modelu si lze zjednodušeně představit takto: pro každý token se musí všechny aktivní parametry modelu “protočit” ve výpočetní jednotce přímo na čipu. Bandwidth v tomto schématu určuje, jak rychle mohou parametry proudit z RAM do výpočetní jednotky. Výkon pak určuje, jak rychle s těmito parametry výpočetní jednotka provede potřebné výpočty. Jeden z těchto parametrů vždy tvoří bottleneck: buď pomalu přitékají parametry do výpočetní jednotky a zdržuje tedy nízký bandwidth (“memory-bandwidth-bound” mód), a nebo je bandwidth dostatečný, ale nestíhají probíhat samotné výpočty (“compute-bound” mód).
Odhad rychlosti: dekódování jedné sekvence
Při dekódování jedné sekvence zároveň nás většinou zdržuje bandwidth. Každá váha se totiž při procesování výstupu načte jednou a připadají na ni pouhé zhruba 2 operace během násobení matic (jedno násobení a jedno sečtení), než ji musíme z výpočetní jednotky odstranit a načíst další váhu. To vyplývá z toho, že tokeny dekódujeme jeden po druhém.
Pokud bychom měli váhy v 8-bitovém formátu (1 byte na váhu), aritmetická intenzita by tedy byla ~2 FLOP/byte. DGX Spark má poměr 500 TFLOPS ÷ 273 GB/s ≈ 1 800 FLOP/byte. Máme tedy v tomto případě zhruba 900-násobnou rezervu, pokud jde o výkon.
Jakmile nás nezdržuje výkon, ale bandwidth, jednoduchý odhad rychlosti dekódování získáme pomocí následujícího vzorce:
tokeny za sekundu = bandwidth (GB/s) ÷ aktivní parametry (GB)Do tohoto vzorce potřebujeme znát, kolik místa zabírají aktivní parametry. To zjistíme vynásobením počtu aktivních parametrů s počtem bytů na parametr. Pro dense modely je počet aktivních parametrů odvozený od celkového počtu parametrů, pro MoE modely jde právě pouze o aktivní parametry.
Tedy u Qwenu 3.8 jsou aktivní všechny parametry a pokud uvažujeme 16-bitovou přesnost, vychází to na 27,8B × 2 byty ~ 56 GB. U DeepSeeku připadá na jeden parametr v průměru 167 GB ÷ 284B ≈ 0,59 bytu (jde o mix 8-bitových a 4-bitových parametrů), takže 13B aktivních parametrů zabere zhruba 7,6 GB.
Po dosazení do vzorce dostaneme následující odhad:
| model / hardware | 2× DGX Spark (546 GB/s) | RTX PRO 6000 (1 792 GB/s) |
|---|---|---|
| Qwen3.8-27B | ~10 tok/s | ~32 tok/s |
| DeepSeek-V4-Flash | ~72 tok/s | ~235 tok/s7 |
Vidíme tedy, že DeepSeek-V4-Flash jako MoE model má potenciál běžet na dvojici DGX Spark zhruba 2× rychleji než Qwen3.8-27B na dedikované GPU, a to i přes to, že je tento model zhruba desetkrát větší.8
Naše teoretické odhady pro DeepSeek na 2× DGX Spark zhruba odpovídají těmto naměřeným výsledkům uživatelů z Githubu.
Ještě je dobré zmínit, jak působí rychlost dekódování (zde je vizualizace těchto rychlostí pro lepší představu):
- 10-20 tokenů za sekundu je na hranici použitelnosti.
- 30-40 tokenů za sekundu je příjemný standard.
- 60-100 tokenů za sekundu se hodí pro kódování a další agentní tasky.
Odhad rychlosti: čtení vstupu
Než model vygeneruje první token, musí nejdřív zpracovat celý vstupní prompt. To je poměrně zásadní u agentů, kde na vstupu figuruje systémový prompt, definice nástrojů a MCP serverů, případně historie konverzace, výstupy nástrojů, atd.
Tahle fáze se označuje jako “prefill” a na rozdíl od dekódování zde můžeme zpracovávat všechny tokeny naráz. Váha modelu se z RAM tedy opět načte pouze jednou, ale místo dvou operací na ni připadají 2 operace × N tokenů.
Při prvním zpracování vstupu se tedy bottleneck překlopí z bandwidth na výkon. Pokud totiž stále uvažujeme 2 operace na token a máme váhy v 8-bitovém formátu (1 byte na parametr), ale tyto operace můžeme najednou aplikovat na 900 tokenů, dostaneme se na 1 800 FLOP/byte, tedy přesně na výkon, který DGX Spark “stíhá”. Jakýkoliv prompt delší než 900 tokenů (hrubý odhad) už bude “compute-bound”.
Odhad pro compute-bound režim proto vypadá takto:
tokeny za sekundu = výkon (FLOPS) ÷ (2 × aktivní parametry na token)| model | hardware | 2× DGX Spark | RTX PRO 6000 |
|---|---|---|
| Qwen3.8-27B | ~18 000 tok/s | ~36 000 tok/s |
| DeepSeek-V4-Flash | ~38 000 tok/s | ~77 000 tok/s7 |
To vypadá hodně slušně. Narazíme zde ale na to, že tyto teoretické výpočty jsou spíš horním odhadem a reálně dosažitelná část špičkového výkonu se u prefillu pohybuje mnohem níže. U dvojice Sparků bude tento výkon navíc snížený o režii na synchronizaci mezi čipy.
Reálně naměřená čísla pro DeepSeek na dvojici DGX Spark vypadají takto:
| prompt tokens | sec | tok/s |
|---|---|---|
| 6 234 | 4,1 | 1 513 |
| 24 900 | 10,9 | 2 284 |
| 77 790 | 29,5 | 2 639 |
Jsme tedy mnohem spíš kolem 2 000 tokenů za sekundu. Je to menší rychlost, než naše teoretické odhady, ale pořád jde o zhruba 30× vyšší rychlost, než rychlost při dekódování.
V interaktivním režimu, kdy agent komunikuje s uživatelem, nás u prefillu zajímá především TTFT (time-to-first-token): čas, za který model přečte vstup a začne generovat odpověď. Ten nám zde určuje prostřední sloupec. Vidíme tedy, že u promptu mezi 10-20k tokenů (typický agentní prompt s historií a výstupy nástrojů) se dostaneme na hodnoty mezi 5-10 sekund od doby, co uživatel zmáčkne Enter, do chvíle, než model začne generovat výstup.
Toto platí pouze pro první interakci s modelem. Každá následující interakce už má režii výrazně nižší, protože jsou předpočítané hodnoty uložené do KV cache.
Odhad rychlosti: více uživatelů zároveň
Jak se čísla změní, když začneme obsluhovat víc požadavků najednou? Odhadnout to není úplně přímočaré. Nestačí vydělit počet tokenů za sekundu počtem uživatelů, zároveň rychlost ale ani nezůstane konstantní.
S více uživateli nám totiž pomůže, že můžeme do nějaké míry uplatnit batchování: tedy váhy modelu se z RAM načtou jednou a použijí se pro všech B sekvencí v batchi současně. To nám ušetří bandwidth: v ideálním stavu vyrobíme za stejný čas B tokenů místo jednoho. S tímto si dokáže skvěle poradit vLLM, které je na provoz pro více požadavků zároveň optimalizované.
Tento ideální stav ale nenastane už jen proto, že každá sekvence má vlastní KV cache. Problém navíc nastává u MoE modelů, které mohou potřebovat využít jinou sadu aktivních parametrů pro každého uživatele.
Odhad celkové propustnosti proto vypadá takto:
tokeny za sekundu (celkem) = B × bandwidth ÷ (aktivní parametry za krok + B × velikost KV cache)U dense modelu je člen “aktivní parametry za krok” konstantní, takže dokud KV cache nepřeroste velikost modelu, roste propustnost skoro lineárně. U MoE modelů se toto škálování rozbije tím, že se v rámci aktivních parametrů aktivují různí “experti” (podmnožina vah) pro jednotlivé požadavky, a tedy ne všechny váhy mohou být sdílené.
Odhad pro kontext 32k na uživatele (Qwen ~2,3 GB KV, DeepSeek ~1,1 GB KV) na dvojici Sparků (s tím, že pro DeepSeek počítám ~50 % aktivních parametrů na routované experty, zbytek je attention a další parametry):
| uživatelů | Qwen3.8-27B (na uživ. / celkem) | DeepSeek-V4-Flash (na uživ. / celkem) |
|---|---|---|
| 1 | ~9 / ~9 tok/s | ~63 / ~63 tok/s |
| 4 | ~8 / ~34 tok/s | ~23 / ~94 tok/s |
| 8 | ~7 / ~59 tok/s | ~13 / ~107 tok/s |
| 16 | ~6 / ~95 tok/s | ~7 / ~116 tok/s |
DeepSeek tedy náskok u jednoho uživatele postupně poměrně rychle ztrácí a u 8-16 souběžných uživatelů může být také neúnosně pomalý.
Pozor je potřeba dávat i na kapacitu paměti, do které se musí vejít KV cache pro každého uživatele (u dvojice DGX Spark by ale měla být rezerva dostatečná).
Naměřené údaje od uživatelů z Githubu opět přibližně odpovídají našim teoretickým odhadům.
Elektřina
Kromě nákupu hardwaru je dobré zmínit i náklady na elektřinu na jeho provoz. Jeden stroj spotřebuje odhadem při provozu ~45 W bez zátěže, ~90 W při běžné inferenci, ~200 W při plné zátěži. Cena elektřiny vychází u ČEZ kolem 4 Kč/kWh.
Pro provoz dvojice NVIDIA DGX Spark tedy platí tyto odhady:
- Dolní odhad: pokud by oba stroje běžely jen zapnuté, vychází to na 45 W × 2 stroje × 24 h = 2,16 kWh × 4 Kč/kWh = ~9 Kč na den, tedy 3 285 Kč na rok.
- Horní odhad: pokud by oba stroje běžely 24/7 naplno, vychází to na 200 W × 2 stroje × 24 h = 9,6 kWh × 4 Kč/kWh = ~40 Kč na den, tedy 14 600 Kč na rok.
Pro srovnání, kancelářské PC s příkonem 70 W a denním provozem (tedy zátěží 8 h / den) vyjde kolem 800 Kč na rok.
Ceny elektřiny tedy nejsou zanedbatelné, ale odpovídají provozu jednotek stolních počítačů navíc.
Závěr
Na AI pracovních stanicích dává smysl provozovat především MoE modely s větším počtem parametrů celkově, ale menším počtem aktivních parametrů. Dedikované GPU mají za podobnou cenu méně paměti, ale násobně vyšší bandwidth, takže se více hodí pro menší dense modely.
Tyto principy jsou platné obecně, konkrétní odhady ale závisí na dostupném hardwaru a modelech. Dá se očekávat, že modely se při stejných hardwarových požadavcích budou už jen zlepšovat. U hardware půjde vývoj dopředu také, ale jeho cena může kvůli vysoké poptávce kolísat a v krátkodobém horizontu se i zvyšovat. Je proto dobré si obojí znovu zanalyzovat těsně před nákupem.
Poznámky
-
Kde “V” je odvozené od “video”, což je pozůstatek původního účelu grafických karet: vykreslování grafiky. ↩
-
Vypadá to, že počet mezi sebou propojených zařízení je obecně neomezený (viz toto Reddit vlákno), vyšší počet ale vyžaduje ruční, neoficiální řešení. ↩
-
Windows může být výhodou pro lidi, kteří chtějí GPU využívat na hraní her. Pro provoz AI modelů v tom žádnou výhodu nevidím. ↩
-
Pro větší počet karet by hardware byl citelně dražší, především kvůli vyšším nárokům na PCIe linky na rychlou výměnu dat mezi grafickými kartami a nákladnějšímu napájení a chlazení. ↩
-
Jde o odhad špičkového výkonu v dense FP4 formátu. Výrobci obvykle inzerují dvojnásobek, ale to jsou hodnoty pro sparsitu, která se u provozu jazykových modelů běžně nevyužívá. Poměr mezi oběma čipy zůstává stejný. ↩
-
Na jednom DGX Spark by tento model šel rozchodit pouze ve dvoubitové kvantizaci, což už může mít značný dopad na kvalitu výstupů. ↩
-
Teoretická hodnota – model se v této kvantizaci do 96 GB nevejde. ↩ ↩2
-
U dvojice Sparků je potřeba využít tensor parallelismus, tedy rozdělení jednotlivých matic mezi oba čipy tak, aby oba počítaly na stejném tokenu současně. Jen v takovém případě se dá bandwidth sečíst (pokud zanedbáme režii na synchronizaci). Výchozí a jednodušší pipeline parallelism, který dělí model po vrstvách, by nechal jeden čip vždy čekat na druhý. ↩