Stejný vstup, stejný výstup
...nebo ne? O (ne)deterministických výstupech jazykových modelů, samplingu a nástrahách paralelismu.
Výsledky experimentů ↗Zkuste zadat jazykovému modelu stejný prompt dvakrát. Co myslíte – dá vám pokaždé stejný výstup?
První reakcí na tuhle otázku by mělo být především: “Proč?” Přece nechceme vysávat vodu, ničit lesy a zabíjet koťátka1 kvůli výstupu, který už model jednou vygeneroval a můžeme si ho tedy vytáhnout z historie.
Otázka by proto měla znít spíš: jsou výstupy modelů deterministické?
To už je celkem rozumný požadavek. Nejen proto, že je inženýrsky uspokojivé, že všichni dostanou na stejný vstup stejnou odpověď. Pomáhá to spolehlivosti a testovatelnosti modelů a umožňuje nám dobře replikovat experimenty. Navíc nechceme ukládat každou odpověď – to je ostatně jeden z důvodů, proč máme všechny znalosti zkomprimované v checkpointu modelu.
Druhou reakcí by mělo být: “Vždyť je to jen počítačový program. Jasně, že mi dá na stejný vstup stejný výstup.”
Pokud si to myslíte, zkuste si to: jednoduchý dotaz, několikrát za sebou, pokaždé v nové konverzaci. Můžete to zkusit přes komerční webové rozhraní, ještě lépe pak s otevřeným modelem na vlastním hardwaru.
Překvapivě je řada důvodů, proč odpověď v obou těchto případech může být “ne”, od těch triviálnějších až po ty záludnější.
Zajímá vás, jestli může být odpověď “ano”? TL;DR: Z otevřených modelů je možné získat deterministické výstupy, ale za cenu znatelně pomalejšího dekódování. Z proprietárních modelů se vám to obecně nepodaří.
Jak modely generují text
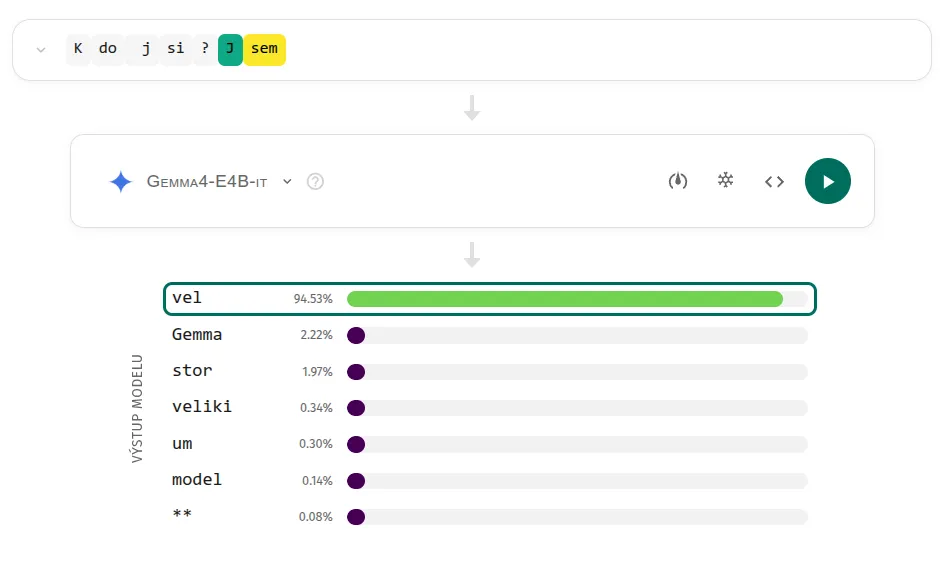
Klíčem k pochopení následujících argumentů je proces, kterým současné jazykové modely generují text:
- Model dostane předdefinovaný tzv. slovník tokenů (sekvencí znaků, ze kterých se může skládat text).
- Při generování textu se pak ve smyčce opakuje následující:
- Model dostane na vstupu text rozdělený na tokeny.
- Model pro každý token ve slovníku vypočítá, jak pravděpodobné je, že může následovat v zadaném textu.
- Na základě pravděpodobností vybereme jeden konkrétní token a přidáme ho na konec existujícího textu.
- Pokud jsme vybrali speciální
EOS(end-of-sequence) token, ukončíme proces generování textu.
Pro lepší představu si můžete tento proces prohlédnout v této interaktivní webové aplikaci na reálných výstupech:
Triviální důvod: Sampling a náhodný seed
Všimněte si, že v aplikaci můžete pro generování textu nastavit i tzv. teplotu :
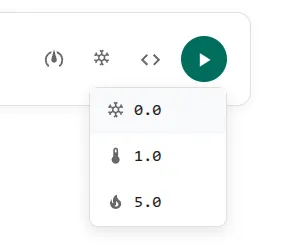
V tom se skrývá ta triviálnější odpověď, proč výstupy z modelů pro stejný prompt mohou být různé.
V předchozím popisu postupu generování textu jsem neřekl, že vybereme ten nejpravděpodobnější token. To se děje jen ve chvíli, kdy nastavíme teplotu , a říkáme tomu “greedy decoding”. Je to celkem přirozená možnost: model nám v každém okamžiku naservíruje token, který je podle něj nejpravděpodobnější.2
Je ale hned několik důvodů, proč bychom chtěli do tohoto procesu vnést i náhodu. Náhoda umožní lépe využít celou pravděpodobnostní distribuci modelu a získat díky tomu různorodější výstupy. Ukazuje se například, že s greedy decodingem se výstupy modelů často zacyklí: jakmile model jednou udělá chybu, dostane se tím do smyčky a chybu dělá stále dokola. Můžeme také třeba chtít pustit řadu agentů, z nichž každý bude objevovat jinou část problému. S greedy decodingem je pravděpodobnější, že se většina agentů vydá stejným směrem.3
Pochopitelně ale nechceme vybírat tokeny čistě náhodně: chceme využít pravděpodobnostní distribuci, kterou nám model vypočítal. Pokud například model přiřadil nejpravděpodobnějším třem tokenům postupně pravděpodobnosti 42 %, 18 % a 5 % (zbylých 35 % je rozdělené mezi zbývající tokeny), chceme si hodit obrazně 100stěnnou kostkou, pro čísla 1–42 vybrat první token, pro 43–60 druhý token, pro čísla 61–65 třetí token atd.
Tahle paralela s kostkou funguje ve chvíli, kdy nastavíme teplotu na . Vyplývá to z následujícího vzorce pro softmax funkci, kterou vypočítáváme výsledné pravděpodobnosti:
Nastavování mezi 0 a ∞ si můžeme představit tak, že ovlivňujeme tvar pravděpodobnostní distribuce. Vyzkoušet si to můžete na tomto fiktivním příkladu:
S teplotou 0 bude distribuce nejostřejší: 100 % pravděpodobnosti připadne na nejpravděpodobnější token. Výstup modelu bude tedy deterministický. Naopak s rostoucí teplotou se pak distribuce vyhlazuje a rozdíly mezi tokeny se stírají – sampling pak to, co model spočítal, prakticky ignoruje.
Dá se teplota nastavit?
Náhodný sampling je ten hlavní důvod, proč z proprietárních AI modelů nedostanete dvakrát stejnou odpověď na stejnou otázku: teplotu u nich totiž většinou nastavit nejde.
To neznamená, že by se v modelu nevyužívala. Dá se předpokládat, že je interně nastavená na konkrétní hodnotu v intervalu , podobně jako je tomu u doporučených hodnot pro otevřené modely (u kterých teplotu dekódovacího procesu nastavit můžeme, alespoň pokud je provozujeme lokálně).
Zajímavé je, že dříve tato možnost dostupná byla i u proprietárních modelů, jako je vidět například zde v OpenAI Playground:
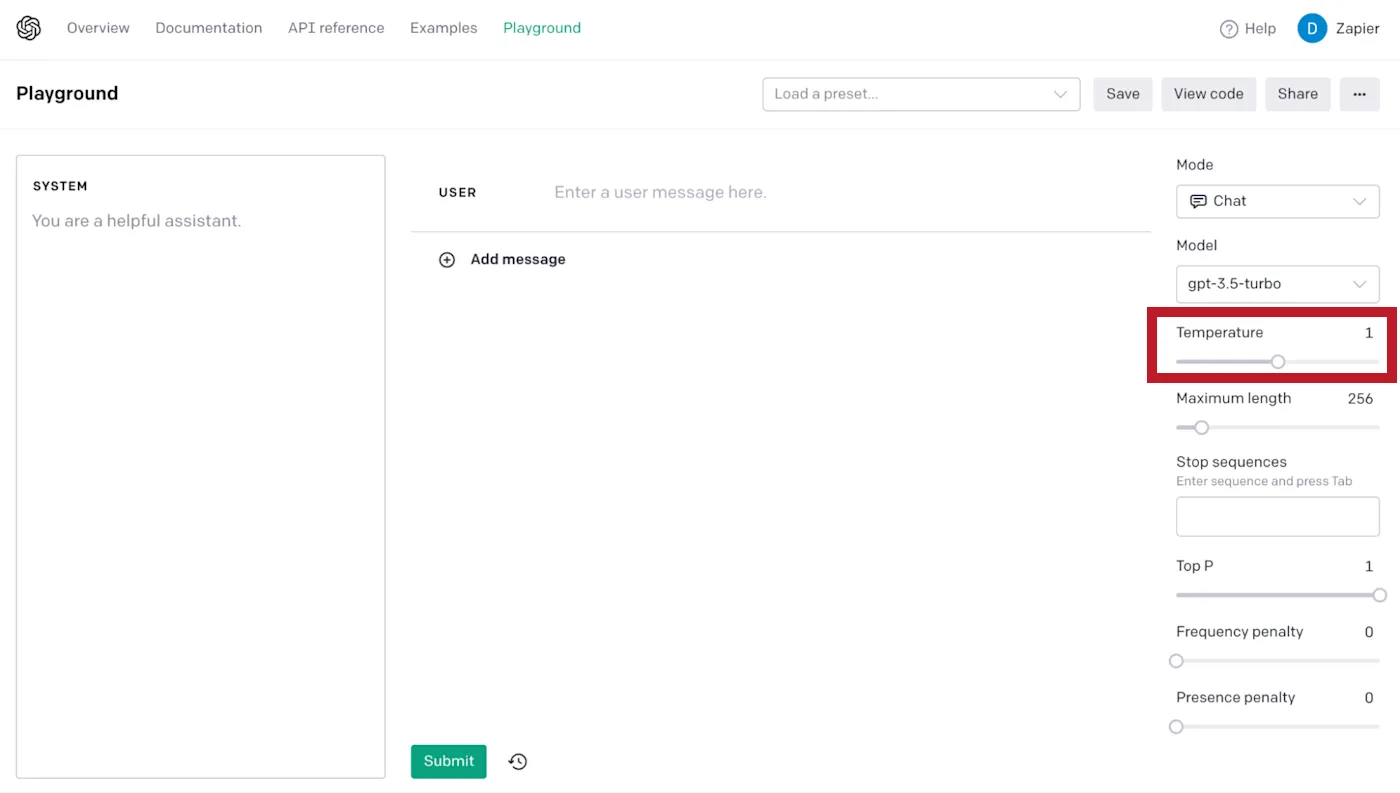
I dnes je tato možnost částečně dostupná přes API, ale pouze u starších generací modelů – u novějších tato možnost postupně mizí (viz např. GPT-6, Claude Opus 5).
Vadí to ale? Lidé znalí programování už v tuto chvíli netrpělivě přešlapují. Vždyť přece stačí zafixovat náhodný seed.4 S tím bude celý proces vypadat náhodně, ale model vždy vybere stejné výstupy.
Jeden úhel pohledu je ten praktický: u proprietárních modelů poskytovatelé často nepodporují ani nastavení seedu (a to ani přes API).5
Je ale důležité pochopit proč to neumožňují (ačkoliv dříve i tato možnost dostupná byla mnohem častěji). Problém totiž je, že ani nastavený seed nezaručuje deterministické výstupy, jak naznačuje v tomto úryvku z dokumentace OpenAI kvantifikátor “mostly”:
Developers can now specify
seedparameter in the Chat Completion request to receive (mostly) consistent outputs.
Vývojáři nyní mohou v požadavku na Chat Completion zadat parametr
seeda získat tak (většinou) konzistentní výstupy.
Je to stejný důvod, proč nám fixní seed (nebo teplota ) nemusí pomoct k deterministickým výstupům ani na našem vlastním hardwaru.
Záludnější důvody: hardware, paralelismus a race conditions
Zatímco v předchozí sekci šlo o přirozený důsledek fungování jazykových modelů, následující důvody by se daly spíše klasifikovat jako vedlejší účinky.
Různý hardware
Drobné rozdíly v hardwaru mohou být první záludnější příčinou nedeterminismu.
Komerční poskytovatelé své modely provozují v obrovských datacentrech, často na několika typech hardwaru zároveň. Anthropic například uvádí, že své modely provozuje na čipech AWS Trainium, grafických kartách NVIDIA a TPU od Googlu. Váš dotaz tak může skončit pokaždé na jiném typu čipu. I pokud pracujete lokálně s otevřenými modely, můžete k tomu používat výpočetní cluster, kde vaše modely poběží na různých grafických kartách.
Různé grafické karty mohou mít různé výpočetní jednotky, jinou podporu datových formátů atd. – a to nejen napříč výrobci, ale i pokud jde o různé generace u stejného výrobce.
Knihovny pro obecné výpočty jako NVIDIA cuBLAS proto nezaručují na různých kartách stejné výsledky:
By design, all cuBLAS API routines from a given toolkit version, generate the same bit-wise results at every run when executed on GPUs with the same architecture and the same number of SMs. However, bit-wise reproducibility is not guaranteed across toolkit versions because the implementation might differ due to some implementation changes.
Všechny funkce cuBLAS API z dané verze toolkitu z principu generují při každém běhu bitově stejné výsledky, pokud běží na GPU se stejnou architekturou a stejným počtem SM (multiprocesorů). Bitová reprodukovatelnost ale není zaručená napříč verzemi toolkitu, protože se implementace může kvůli změnám lišit.
To samé platí například pro knihovnu pro strojové učení PyTorch, která nezaručuje reprodukovatelné výsledky napříč verzemi, platformami nebo mezi CPU a GPU.
Race conditions
Problém s nedeterministickými výstupy ale může nastat i při opakování stejného vstupu za stejných podmínek na stejné grafické kartě.6 Jak se to může stát?
Pojďme začít vysvětlením, které – jak se ukázalo – není úplně přesné, ale pomůže nám téma lépe pochopit.
Jsou aritmetické operace na grafické kartě:
- které jsou prováděné paralelně, a tedy mohou doběhnout v náhodném pořadí,
- ve kterých různé pořadí operandů může vést k různému výsledku.
Prvnímu bodu se není potřeba divit. Paralelismus je klíčem k tomu, proč jsou grafické karty tak účinné pro provoz AI modelů, a drobné odchylky v časování vláken (“race conditions”) dělají tento proces nedeterministickým.
Proč se ale mohou výsledky lišit v závislosti na pořadí, pokud se bavíme o aritmetických operacích typu sčítání a násobení v daném vzorci?
Hlavním viníkem je omezená přesnost desetinných čísel typu float v počítači. Matematicky je sčítání desetinných čísel asociativní: (a + b) + c je to samé jako a + (b + c).
V počítači tomu tak ale není, protože čísla typu float mají zhruba fixní počet platných číslic. Malá čísla proto mohou být uložena v mnohem vyšší přesnosti než velká, a při sčítání dvou řádově odlišných čísel se to menší z nich musí zaokrouhlit. To je daň za dynamický rozsah, který nám tato reprezentace umožňuje.
Pokud máte po ruce Python, můžete si to vyzkoušet sami:
V prvním případě bylo potřeba nejprve převést hodnoty 0.1 (jedna desetina) a 1e20 (sto trilionů) na stejný řád. V mezivýsledku v řádu stovek trilionů jedna desetina zanikla, výsledkem je tedy (nepřesně) nula.
Je navíc potřeba myslet na to, že zatímco běžný 64bitový float v Pythonu udrží zhruba 16 platných číslic, formát bfloat16 používaný běžně pro jazykové modely jen 2–3.
Kde se tyto rozdíly projeví při inferenci? Například při operacích typu skalární součin. Zde používáme operace typu torch.sum(), které redukují vektor na skalární číslo:
Provádět tento součet v pevně daném pořadí by znamenalo nejdřív počkat na to, než dostaneme z předchozích výpočtů všechny sčítance. Tím bychom ovšem ztráceli výpočetní čas.
Pokud to ale dělat nebudeme, může se stát, že kvůli drobným výkyvům v rychlosti paralelních výpočtů budou čísla sčítána v různém pořadí. A jak jsme si ukázali, kvůli zaokrouhlovacím chybám můžeme následně dostat různé výsledky.
Deterministický z pohledu koho?
Ještě rok zpátky byl právě tento problém označovaný za hlavního viníka nedeterminismu na jednotném hardwaru (alespoň podle hrstky zdrojů v podobě diskuzí na fórech, empirických experimentů a náznaků v dokumentaci).
V září 2025 ale v této oblasti odstartoval novou éru blogpost Defeating Nondeterminism in LLM Inference od Thinking Machines. Autoři zde tvrdí, že nedeterministické operace sčítání vektoru při inferenci nejsou problém, protože se jim současné implementace knihoven pro LLM inferenci vyhýbají:
Over time, most neural network libraries have adopted a variety of strategies for achieving determinism without sacrificing performance. For example, we can perform a “split” (or tree) reduction, where we split the 100-element reduction into five 20-element reductions (thus achieving five-way parallelism). Then, to combine the remaining five elements, we can either perform a separate “clean-up” reduction (which isn’t parallelized, but operates over few enough elements to be cheap) or utilize a semaphore (which ensures that each concurrent thread-block will accumulate in a deterministic order).
Většina knihoven pro neuronové sítě postupem času přijala řadu strategií, jak dosáhnout determinismu bez ztráty výkonu. Můžeme například provést „rozdělenou“ (neboli stromovou) redukci, kdy redukci 100 prvků rozdělíme na pět redukcí po 20 prvcích (a dosáhneme tak pětinásobného paralelismu). Zbývajících pět prvků pak můžeme zkombinovat buď samostatnou „úklidovou“ redukcí (ta paralelní není, ale pracuje s tak malým počtem prvků, že je levná), nebo použít semafor (ten zajistí, že každý souběžně běžící blok vláken přičte svůj výsledek v deterministickém pořadí).
A přesto to vypadá, že tento problém stále není vyřešený.
Kdo je tedy viníkem? Podle autorů článku je tomu tak kvůli tomu, že operace nejsou invariantní vůči batchi. Jinak řečeno, mohou za to ostatní uživatelé, kteří zároveň posílají požadavky na stejný inferenční server:
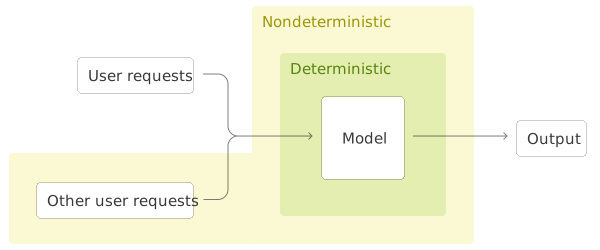
Představte si, že máme uživatele A, B, C a D. Tito uživatelé chtějí v jednu chvíli vygenerovat další token od našeho modelu s N vrstvami.
Kdybychom postupovali naivně, nejprve se soustředíme na uživatele A. Proženeme jeho vstup vrstvami modelu č. 1, 2, 3 až N a vrátíme mu výstupní token. Následně uděláme to samé i pro uživatele B, C a D.
Všimněte si, že se v tomto případě musela postupně každá vrstva modelu vystřídat na čipu 4×. Každý tento přesun nás stojí bandwidth (propustnost), který – jak jsme si vysvětlili v článku o hardwaru – bývá často omezující faktor.
Můžeme ale postupovat chytřeji: nejprve si na čip nahrajeme vrstvu modelu č. 1 a spočítáme výstupy pro uživatele A, B, C a D. Následně uděláme to samé i s vrstvou č. 2, 3, atd. Když dojdeme do vrstvy N, máme hotové výstupy pro všechny čtyři uživatele, zatímco se celý model na čipu musel protočit pouze jednou. To je podstata batchování – způsob, jak zvýšit celkovou propustnost serveru při generování odpovědi pro více uživatelů.
S batchováním se ale z vektorů stávají matice a nad těmi může inferenční server provádět různé optimalizace, kterými se snaží naplno vytížit výpočetní jádra.
Pokud je například matice při skalárním součinu dostatečně velká, každé GPU jádro si vezme vlastní část výstupu a celý skalární součin si sečte samo. Pokud je ale uživatel jen jeden, mezi jádra se rozdělí i samotné sčítání: každé jádro sečte jen úsek vektoru a mezivýsledky se nakonec sloučí. Pro různý počet požadavků v batchi se tedy použije jiný typ operace.
Problémem je i tzv. chunked prefill (zpracování vstupu po částech), při kterém se vstupy od uživatelů porcují do sekvencí přesně dané délky. Kde přesně se sekvence rozdělí, opět záleží na tom, jak vypadají ostatní sekvence v batchi:
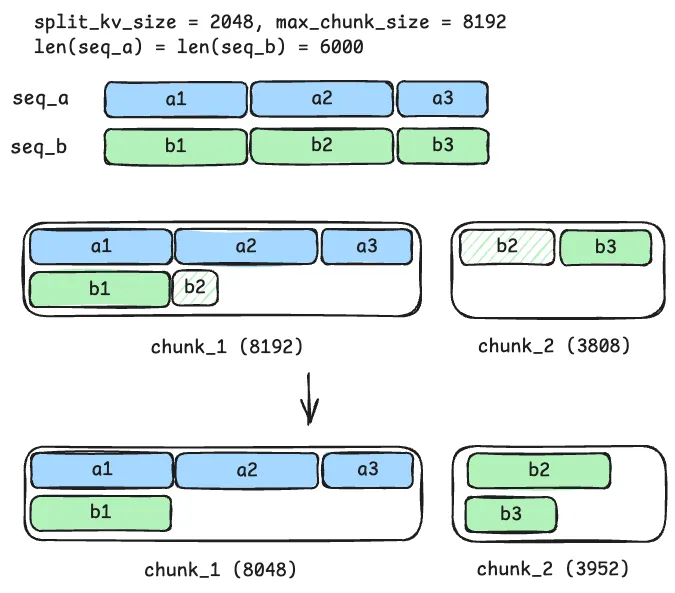
Z pohledu celé batche jsou výstupy modelu deterministické, celková náplň batche se ale bude pokaždé lišit.
Je také dobré si uvědomit, že problém nemusí nastávat jen s více uživateli – stačí více požadavků najednou. Pokud tedy na inferenční server pošlete několik požadavků paralelně (třeba z několika agentů najednou), stáváte se sami sobě těmi “ostatními uživateli”.
Jak se nedeterminismus projevuje?
Pojďme se podívat, jak se může tento hardwarový nedeterminismus projevovat na výstupech.
Na rozdíl od samplingu, kde jiný seed může vést k zásadně jiným odpovědím už od prvního tokenu, zde jde často o drobné numerické odchylky. Ne každá numerická odchylka znamená nutně jiné výstupy. Stačí ale jediné místo, kde se model rozhodne vybrat jiný token: od té chvíle už se mohou odpovědi začít rozcházet poměrně zásadně.
Ve zmíněném blogpostu nechali Thinking Machines model Qwen3-235B-A22B vygenerovat 1000× odpověď na prompt „Tell me about Richard Feynman“ s teplotou 0. V této sadě bylo celkem 80 unikátních odpovědí. Zajímavé je, že prvních 102 tokenů bylo vždy stejných: teprv na 103. tokenu se cesty poprvé rozešly. 992 odpovědí pokračovalo slovy “Queens, New York”, zbylých 8 slovy “New York City”.
Podobný experiment provedli i LMSYS s menším modelem Qwen3-8B: při 50 opakováních stejného promptu dostali v některých testech až 18 různých výstupů.
Oba tyto články zároveň nabízejí i řešení, které vede k deterministickým výstupům. U Thinking Machines jsou to konkrétně kernely pro PyTorch a s tím související inferenční procedury pro vLLM, které jsou invariantní k batchím a které jsou dnes ve vLLM dostupné s flagem VLLM_BATCH_INVARIANT=1. LMSYS pak podobné řešení (na základě původního článku od Thinking Machines) integrovali do vlastního frameworku SGLang.
Je to ale něco za něco: deterministické výstupy jsou znatelně pomalejší. LMSYS uvádí zpomalení o 25–45 %, Thinking Machines dokonce 61,5 %.
Vlastní experimenty
Pro účely tohoto článku jsem se to rozhodl otestovat vlastními experimenty s využitím infrastruktury Metacentra.
Zajímalo mě následující:
- Dokážu se správným nastavením replikovat nedeterministické/deterministické výstupy?
- Jsou nějaké rozdíly mezi modely, inferenčními frameworky a grafickými kartami?
- Jak moc se zpomalí výstup s deterministickou inferencí?
Otestoval jsem to na pěti různých anglických promptech (plné znění najdete v repozitáři). Pro každý prompt jsem proces generování pustil 10× po sobě.
Využil jsem k tomu dva frameworky, se kterými mám zkušenosti: vLLM a llama.cpp, a tři otevřené modely různých velikostí a typů:
| Model | Architektura | Přesnost vah | Grafické karty |
|---|---|---|---|
| LFM2.5-350M | dense, hybridní (konvoluce + attention) | BF16 | A100, L40S |
| Qwen3-4B-Instruct-2507 | dense, klasický transformer | BF16 | A100, L40S |
| Qwen3.6-35B-A3B-NVFP4 | MoE, hybridní (Gated DeltaNet + attention) | NVFP4 (experti), FP8 (attention) | RTX PRO 6000 Blackwell |
Generování probíhalo s teplotou 0 (tam, kde není uvedeno jinak), s vypnutým reasoningem a maximální délkou výstupu 1024 tokenů.
Všechny výstupy najdete v interaktivním prohlížeči, kód a podrobný report najdete na GitHubu.
Experiment č. 1: je batch=1 deterministická?
V prvním experimentu jsem pustil vše s batchí o velikosti 1. Předpokládal jsem proto, že výstupy budou dokonale deterministické.
Téměř ve všech konfiguracích jsem dostal výstupy podle očekávání: s každým opakováním stejný výstup. Výjimkou byl ale model Qwen3.6-35B-A3B ve vLLM, kde se naopak odpovědi lišily napříč běhy u všech pěti promptů (u čtyř z nich byl každý z deseti běhů jiný, u krátkého hello se odchýlil jeden běh).
Tady si můžete prohlédnout všech deset výstupů Qwen3.6-35B-A3B pro prompt story.
Zvýrazněné je vždy místo, kde se daný běh poprvé odchýlil od prvního:
Čím to může být? Tím, že se mixture-of-experts modely mohou chovat jinak, se zabývá tento blogpost, který je ale dnes už poměrně zastaralý a míří na již zmiňovaný problém nedeterminismu kvůli batchování. Navíc stejný model na stejné kartě s llama.cpp běžel deterministicky. Podezřelé jsou tedy nejspíš kernely, které pro architekturu Qwen3.6-35B-A3B používá vLLM.
Vypadá to tedy, že i přes ujišťování, že inferenční knihovny už přešly na deterministické rutiny, může nedeterminismus vystrčit nečekaně růžky.
Pro úplnost jsem ve stejném nastavení vyzkoušel i sampling s teplotou 0,7 a 1 a pevně nastaveným seedem. Výstupy byly opět deterministické u všech modelů v obou frameworcích, s výjimkou Qwen3.6-35B-A3B ve vLLM.
Experiment č. 2: stanou se s větší batchí výstupy nedeterministické?
Ve druhém experimentu jsem ke každému promptu přidal do stejné batche další, náhodně vybrané prompty (batch o velikosti 2, 4 a 8).7 Tady se již dalo očekávat, že výstupy začnou být nedeterministické.
Každý koláčový graf ukazuje červeně, kolik z celkem 50 běhů (5 × 10 výstupů) se lišilo od výstupu s batchí 1:
Hypotéza s nedeterminismem u větších batchí se tedy potvrdila. Ve vLLM dalo stejnou odpověď jako s batchí 1 jen 2–38 % běhů, v llama.cpp 18–54 %.
Experiment č. 3: kolik stojí determinismus?
Ve třetím experimentu jsem se pokusil determinismus ve vLLM vynutit pomocí VLLM_BATCH_INVARIANT=1.
I tady jsem ale narazil: LFM2.5 tento mód nepodporuje kvůli konvolučním vrstvám, Qwen3.6 zase kvůli tomu, že jsem ho používal ve 4bitové kvantizaci.
Je to důvod, proč jsem v experimentech využil Qwen3-4B, ačkoliv jsem chtěl původně použít novější Qwen3.5-4B – starší model má poměrně standardní architekturu a mohl jsem tedy tento mód vyzkoušet alespoň na něm.
Zde tento mód funguje: bez ohledu na velikost batche jsem dostal pokaždé stejnou odpověď. Daň je ale poměrně vysoká, inference byla zhruba třikrát pomalejší:
Experiment č. 4: záleží na hardwaru?
Na závěr jsem pustil první experiment (teplota 0, batch 1) na grafické kartě L40S místo A100. Tabulka ukazuje, u kolika z pěti promptů se odpověď změnila oproti A100:
| Framework | LFM2.5 | Qwen3-4B |
|---|---|---|
| vLLM | 3 | 4 |
| llama.cpp | 0 | 0 |
Pozor na interpretaci: na L40S bylo opět všech deset opakování stejných, tento výstup se pouze u vLLM občas lišil od výstupu na A100. vLLM na rozdíl od llama.cpp volí pravděpodobně pro každou kartu jiné kernely. llama.cpp se tedy (alespoň v těchto experimentech) chová předvídatelněji než vLLM.
Shrnutí
Determinismus výstupů je souhra mnoha faktorů: architektury modelu, inferenčního enginu, grafické karty a velikosti batche. Bez detailního technického porozumění celému inferenčnímu stacku je to tedy spíše o štěstí.
Pokud chcete mít jistotu, že výstupy budou opravdu deterministické, můžete ale využít batch-invariantní režim ve vLLM (VLLM_BATCH_INVARIANT=1) nebo deterministický režim v SGLang (--enable-deterministic-inference).
Musíte ale počítat s tím, že inference bude znatelně pomalejší, že ne každý model je podporovaný, a že to navíc funguje jen pro stejný hardware a stejnou verzi softwaru.
A komu tím pomůžete?
Ještě je dobré se pozastavit nad tím, jak moc je tento problém potřeba řešit v praxi.
U agentů nám starosti s determinismem můžou být na míle vzdálené. Agenti typicky během svého běhu stahují aktuální informace z internetu, čtou dokumenty, které se od posledního běhu mohly změnit, případně i čtou ze své paměti. Jejich výstup bude tedy celkem přirozeně v každém běhu jiný.
Zavařit nám tu může třeba i systémový prompt (tedy část promptu, kterou uživatelskému promptu předřazuje poskytovatel modelu). Například v systémovém promptu Claude modelů je schované dnešní datum – konverzace se stejným uživatelským promptem se tedy může jednoduše lišit kvůli těmto rozdílům na pozadí.
Jinak tomu ale může být v případě, že nasazujeme model ve vysoce kontrolovaném prostředí. Pokud máme například malý model finetunovaný pro parsování požadavků od uživatele do JSON formátu, je naprosto validní chtít, aby výstupy modelu byly deterministické. Může nám to hodně zjednodušit testování a ani nám v tom případě nemusí vadit za to zaplatit pomalejšími výstupy.
Stejně tak se mohou deterministické výstupy hodit pro replikovatelné experimenty. Pokud dokážete zaručit deterministické výstupy, můžete prostředí zabalit do Docker kontejneru, popsat použitý hardware a mít jistotu, že ostatní dostanou stejné výstupy doufat v nejlepší.8
Obecně je dobré mít na paměti tři věci:
- vědět, že problém s nedeterminismem existuje,
- chápat, jak se tento problém dá řešit,
- vědět, kdy ho opravdu potřeba řešit je.
Poznámky
-
Naštěstí to s energetickou náročností AI modelů není tak žhavé (i když zůstávat efektivní neuškodí). ↩
-
To ještě neznamená, že je to nejpravděpodobnější odpověď celkově. Pokud vás to zajímá, povídám o tom například ve své přednášce na MFF o LLM inferenci (kolem 44. minuty). ↩
-
Dalším argumentem pro sampling může být, že nám náhoda umožňuje vodoznakovat výstup z modelů. ↩
-
Pochopitelně na 42. ↩
-
Alespoň OpenAI a Anthropic. U Gemini tato možnost dostupná je. ↩
-
To už programátoři nervózně prokřupávají klouby. ↩
-
U llama.cpp jsem pustil server s 2, 4 a 8 paralelními sloty (
--parallel N) a souběžně s promptem na něj posílal požadavky dalších N−1 klientů. ↩ -
Podpora deterministických operací je zatím experimentální, v kritických situacích bych na ni proto nespoléhal. ↩