Newsletter #3: Jen o čtyři měsíce
Mozilla vydala report o otevřených modelech, AI svět znovu objevil klasifikátory, Huawei bude dodávat čipy pouze do Číny a Anthropic varuje před GLM-5.3.
Vítejte u třetího newsletteru Lokální.AI o otevřených AI modelech!
Uběhl další měsíc, a zatímco se celý vlak AI modelů řítí dopředu svým zběsilým tempem, vypadá to, že si svět pomalu začíná uvědomovat, že otevřený AI ekosystém je potřeba brát vážně.
Otevřené modely šlapou frontier modelům na paty
Mozilla vydala report The state of open source AI, který mapuje stav otevřených AI modelů. Potvrzuje v něm to, co se v poslední době ozývá ze všech stran: otevřené modely jsou zhruba čtyři měsíce pozadu za proprietárními modely.
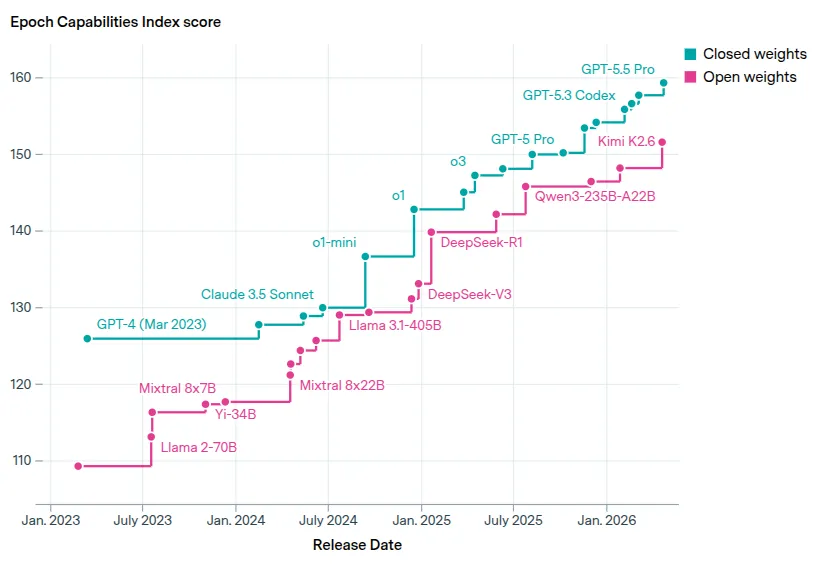
To je nečekaně málo. Znamená to například, že pokud jste před půl rokem spokojeně využívali Claude Opus 4.6 nebo GPT-5.4, nejlepší otevřené modely už jsou dnes lepší.
Často skloňovaným souslovím je ale “jagged frontier” – tedy fakt, že modely jsou někde o hodně napřed, ale jinde překvapivě propadají. V čem tedy modely mezi sebou porovnáváme?
Mozilla jmenuje tři sady benchmarků: AA Intelligence Index, Epoch Capabilities Index a METR time horizons. Benchmarky v těchto sadách se především zaměřují na schopnosti modelů odpovídat na faktické dotazy, řešit úlohy z oblasti přírodních věd, psát počítačový kód, plnit dlouhodobé agentní úkoly a řešit úlohy v kyberbezpečnosti.
Málo nebo vůbec se v těchto benchmarcích projevují aspekty jako multilingualita, styl a kvalita odpovědí, případně třeba spotřeba tokenů na přemýšlení. Zde mohou tedy otevřené modely zaostávat víc.
Trochu víc do šířky jde následující přehled, který skóruje devět vrstev open-source AI ekosystému od infrastruktury až po agentní vrstvu:
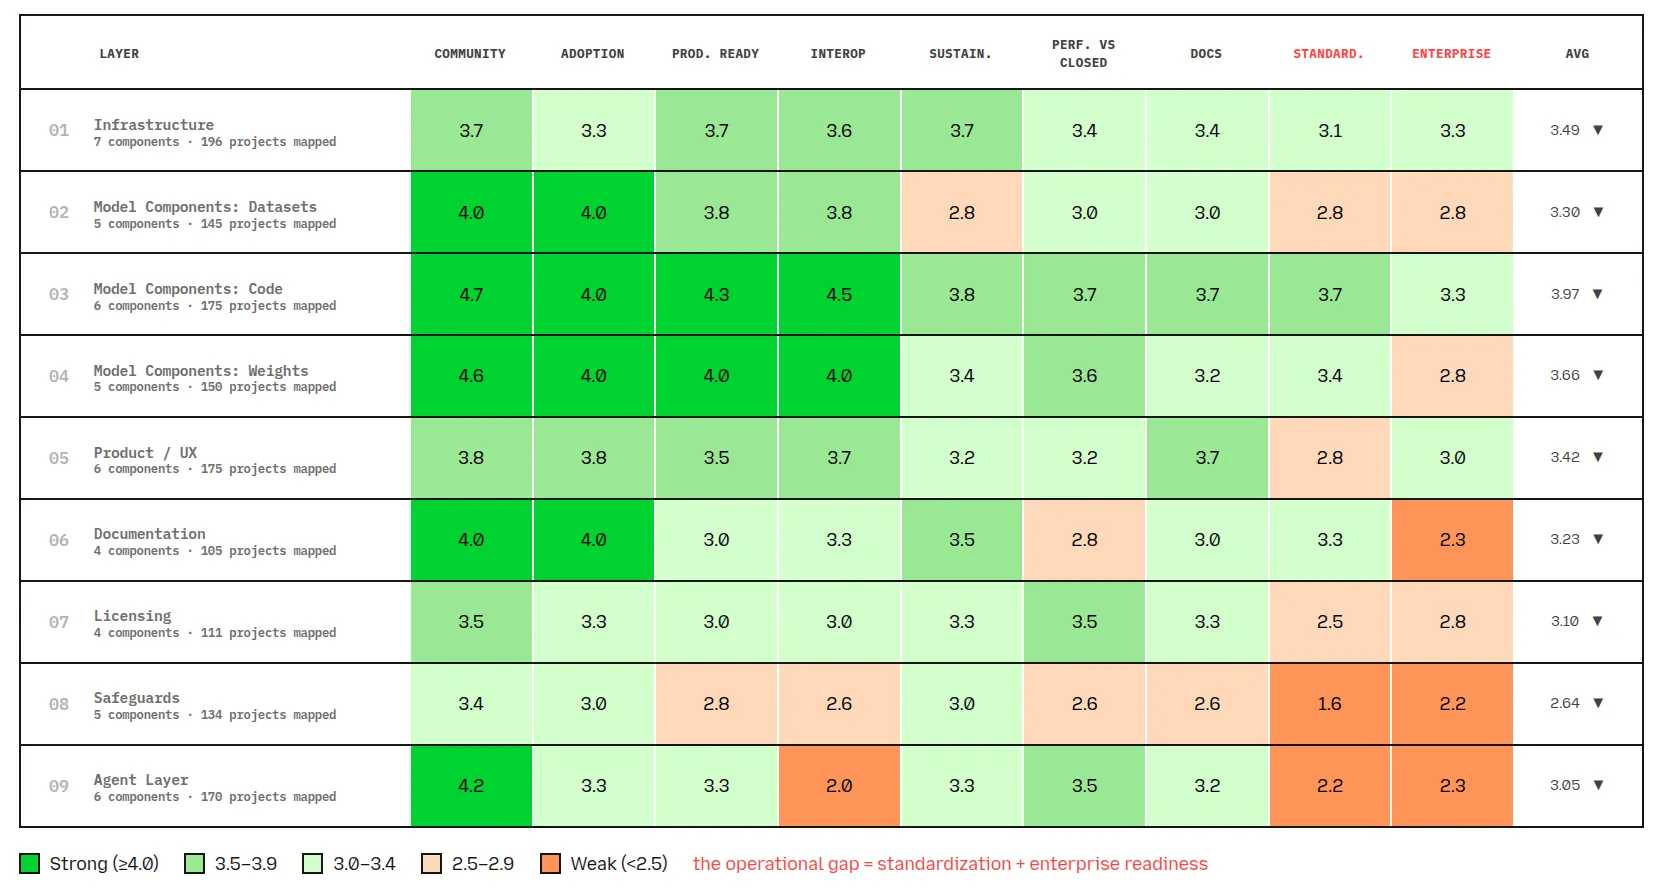
Podle něj to vypadá, že problematickými oblastmi pro otevřené modely jsou například bezpečnostní záruky, licence dat, interoperabilita softwaru nebo kvalita dokumentace.
Naopak napřed je otevřený ekosystém v licencování modelů, frameworcích pro inferenci a finetuning modelů nebo dostupnosti evaluačních benchmarků.
Dál se v reportu od Mozilly dočteme:
- Ceny komerčních API u open modelů jsou relativně nízké. Platí to jak ve srovnání s minulými modely (v poměru ke schopnostem), tak ve srovnání se současnými proprietárními modely.
- 8 z 10 nejvyužívanějších modelů za srpen na OpenRouteru byly otevřené modely. Jediný nečínský otevřený model byl Nemotron 3 Ultra.
- Otevřené modely se zatím příliš nedostávají do produkce. Může za to částečně nižší důvěra a chybějící smlouvy s dodavateli, ale zároveň i to, že schopnosti otevřených modelů v enterprise aplikacích jsou nižší.
- Vývojáři ale otevřené modely využívají ve velkém. Konkrétně podle Mozilla/SlashData 2026 developer survey 79 % vývojářů používá otevřené modely a 71 % používá proprietární modely (zhruba polovina ze všech vývojářů tyto možnosti kombinuje).
- I na otevřených modelech se dá postavit business model. Důkazem toho jsou přímo vývojáři otevřených modelů jako Mistral nebo DeepSeek, ale i platformy typu Databricks. Tyto firmy vydělávají na poskytování výpočetního výkonu, enterprise aplikací, finetuningu a různých pomocných nástrojů.
AI svět znovu objevil klasifikátory
AI světem hýbe Jev. Co to je zač? Zero-shot klasifikační model – tedy model, který dokáže dát pravděpodobnost pro odpovědi na libovolný dotaz.
Jak moc jde o převratný nápad? TypeSafe, kteří tento model uvedli, se snaží do světa protlačit, že hodně. Tvrdí, že se jedná o nové paradigma tzv. “System 1” modelů, které se dovedou na rozdíl od “System 2” modelů typu LLM rozhodovat instantně. Vstup zpracují paralelně, nespotřebovávají výstupní tokeny, mají přesně definovaný výstup – a přitom jsou pořád “inteligentní”.
Pokud jste prošli základy strojového učení, nebo jste dokonce sledovali éru zpracování přirozeného jazyka kolem roku 2021, kdy všemu vládly enkodéry typu BERT, pak vás pravděpodobně tato prohlášení – na rozdíl od velké části Twitteru a LinkedInu – nechávají chladnými.
Zero-shot klasifikátory tu jsou už minimálně od roku 2019. Je pravdou, že doteď byly spíš přehlíženým otloukánkem, a Jev je dobře odladěný produkt, který tento nápad dovedl prodat.
Jev je ale tak uzavřený, jak jen jde. Není zdarma, nestáhnete si ho, neexistuje o něm systémový report a jeho vývojáři ho zatvrzele odmítají podrobit benchmarkům.
Open-source svět se na to pochopitelně ozývá. Nejdál došel vývojář, který se nejprve na Redditu ozval s tím, že model stejného typu publikoval už před rokem, a to včetně trénovacího datasetu, doprovodného článku a modelu samotného. A nešlo o náhodný výkřik: tento vývojář se s podporou open-source komunity do svého projektu znovu opřel a po pár dnech model začal žít druhým životem pod jménem Laya.
Zatím to vypadá, že Laya je plnohodnotný soupeř Jeva. Vznikají verze tohoto modelu dotrénované na určitých typech úkolů jako agentní rozhodovací procesy nebo ovládání prohlížeče, verze s obrázkovým vstupem, verze pro 100+ jazyků, atd.
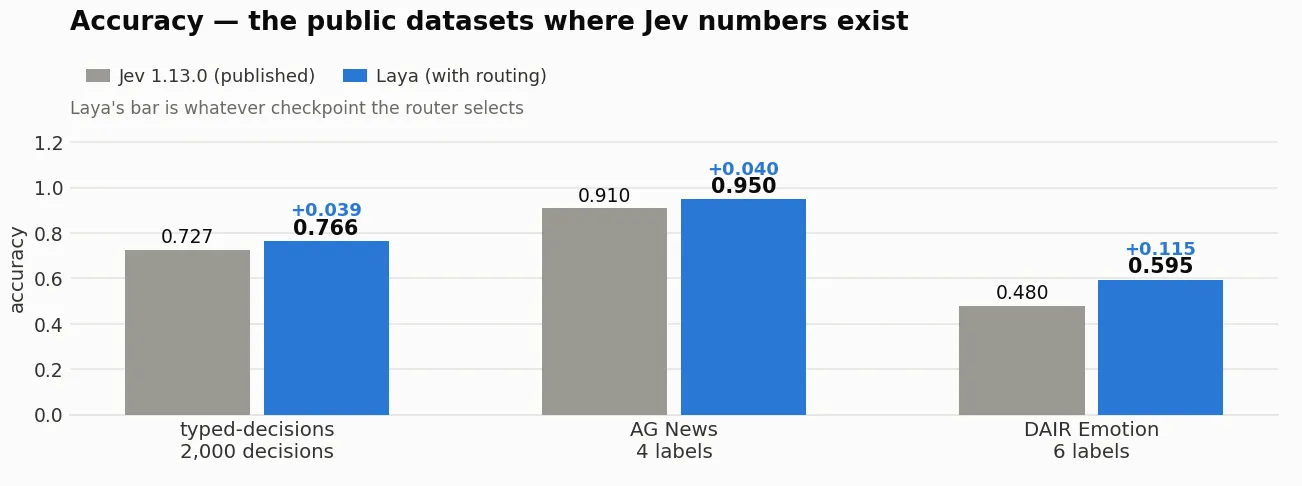
Komunita také začala modely pořádně benchmarkovat a ukazuje se, že Jev není tak božský, jak se snaží jeho vývojáři tvrdit. Například porovnání přímo v repozitáři modelu Laya ukazuje, že v některých oblastech je Laya lepší a rychlejší:
Základem modelu Laya mimochodem není nic jiného než “starý dobrý” BERT (respektive jeho reinkarnace ModernBERT a mmBERT).
Jak už je navíc v open-source světě dobrým zvykem, alternativa není jen jedna. Dalšími jsou například Contrastive Language Models (CLMs) postavené nad modelem Nemotron nebo modely openjev a Kev postavené nad Qwen3.5. A jak dobře připomíná blogpost Jev in 25 lines of Python, technicky se dá model se stejným rozhraním postavit nad libovolným generativním jazykovým modelem.
Ve výsledku je dobře, že na sebe tento typ modelů přitáhl pozornost AI světa a ukázal lidem, že AI není jen o generativních jazykových modelech. Jsou úlohy, na které se mnohem víc hodí jednoduchý klasifikátor.
Čína nestíhá domácí poptávku po AI hardwaru
Huawei oznámil, že další generaci svých AI akcelerátorů Ascend nebude nabízet mimo domácí trh. Nejde o součást geopolitického boje, alespoň ne prvoplánově: Huawei jednoduše nestíhá domácí poptávku.
Jak k tomu došlo? Dovoz AI čipů z USA je dlouhodobě problematický. Vývoz těch nejsilnějších čipů od NVIDIA a AMD byl už v letech 2022–23 zakázaný, firmy proto dlouho dovážely na čínský trh oslabené verze těchto čipů. Tyto restrikce podléhají Trumpovým náladám a pravidla se postupně rozvolňují. V poslední době to ale vypadá, že Čína už čipy z USA naopak spíš nechce.
V oblasti AI hardwaru tu totiž vyrostl silný paralelní ekosystém. Ve výkonu na jeden čip sice čínské čipy stále zaostávají za svými americkými protějšky, a to i v dlouhodobém výhledu, ale Huawei to dohání cenou a škálováním. Čipů vyrábí víc a propojuje je do výkonných clusterů.
Tento přístup teď naráží na limity, zpráva je ale jasná: po AI čipech je v Číně hlad, a čínské technologie budou brzo soběstačné. Podle TrendForce domácí čipy letos obsadí téměř 90 % čínského trhu s high-end AI čipy.
”Mythos has no moat”
Anthropic varuje před tím, že otevřený model GLM-5.3 má podobné schopnosti hledání zranitelností v softwaru, jako jejich model Mythos Preview. Zmiňují, že na rozdíl od jejich projektu Glasswing ale model nikdo předem nezpřístupnil vybraným firmám, aby mohly předem hledat zranitelnosti ve svém softwaru, a model je volně dostupný na Hugging Face.
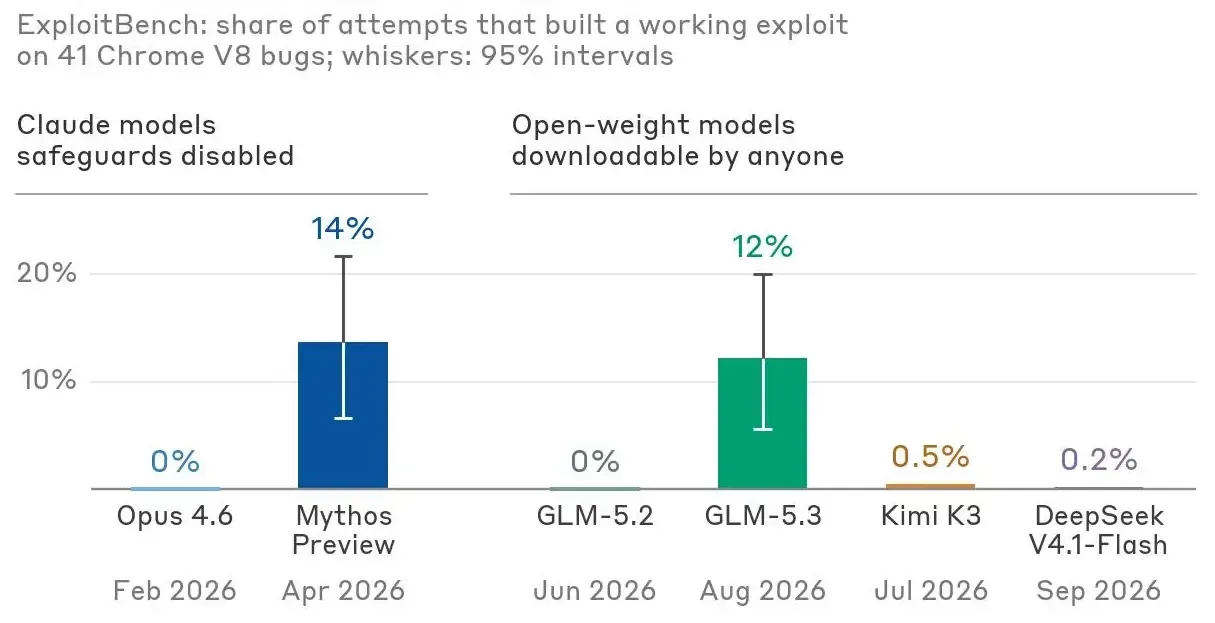
Je tedy možné, že i další firmy začnou “zářit” na FelonyBench – parodickém benchmarku, který počítá, kolik dalších firem hacknuli vaši AI agenti.
Je to celé především nezodpovědnost a nebezpečí, jak naznačuje Anthropic, nebo je důležitější z toho vyplývající demokratizace a decentralizace AI nástrojů? Víc je toto téma probírané v blogpostu o necenzurovaných modelech.
Zásadní je, že zodpovědnost za všechny případné útoky stále nesou samotné firmy a jednotlivci, ne agenti.
Blog Lokální.AI jede!
Na webu Lokální.AI během posledního měsíce vyšly následující blogposty:
- Provozujeme AI lokálně: Hardware na pracovní stůl – Vyplatí se investovat do AI pracovní stanice, nebo do dedikované GPU?
- Necenzurované modely jako legitimní nástroj – Proč AI asistenti občas nespolupracují a jak se to dá změnit?
- Ochrana dat: co nabízejí komerční poskytovatelé? – Stačí nám záruky od komerčních poskytovatelů, nebo chceme opravdu lokální AI?
Tento newsletter byl odeslaný e-mailem přihlášeným odběratelům. Novinky i blogposty se také průběžně objevují na našem Discordu.